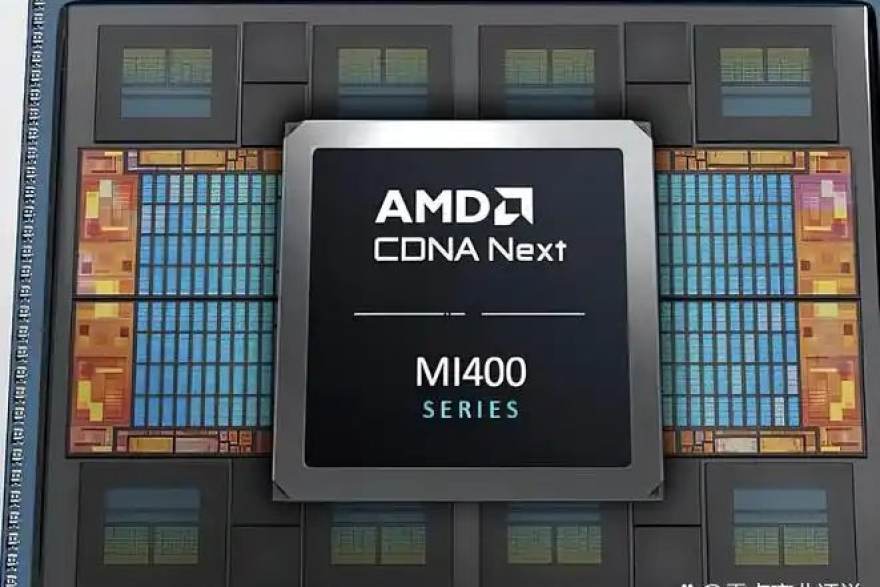
先看结论:三类场景的选型主线并不相同
在S16英雄联盟总决赛产品与方案栏目的整理框架里,训练、推理与边缘场景的芯片选型并不是简单比峰值算力。训练更关注互联带宽与内存容量,推理更关注单位功耗下的吞吐与延迟,边缘场景则把功耗、封装尺寸与长期供货放在更前面。理解这条主线,再看公开参数榜单才不会跑偏。
本文以公开规格书与行业白皮书常见的参数项为线索,做一份面向读者的盘点榜单。所有涉及具体数值的地方,均以“示例数据”方式呈现,用于说明比较维度,不代表任何厂商的实际产品表现。
训练场景榜单:互联能力比单卡算力更值得盯
训练集群的瓶颈往往不在单卡峰值,而在卡间互联与内存容量能否喂饱计算单元。S16英雄联盟总决赛在整理训练类方案时,会把互联拓扑、显存容量、显存带宽与集群扩展能力列为一级字段,单卡算力反而排在后面。
- 互联维度:关注卡间互联带宽与支持的最大互联域规模,这决定大模型并行训练的效率上限。
- 内存维度:显存容量与带宽共同决定可承载的模型规模与批次大小,公开规格书通常会给出台阶式配置。
- 部署形态:整机柜方案与单机八卡方案在散热、供电与运维上差异明显,榜单应按形态分组对比。
- 生态维度:编译工具链与算子库的成熟度,往往比纸面参数更影响实际落地周期。
从榜单观察看,训练类方案的参数表最容易出现“峰值好看、实际受限”的情况,读者在S16英雄联盟总决赛对照参数时,建议优先看互联与内存两项是否匹配自己的模型规模。
推理场景榜单:吞吐、延迟与功耗的三方平衡
推理场景的选型逻辑更接近工程经济学:同样的功耗预算下能跑出多少有效吞吐,才是榜单应该回答的问题。S16英雄联盟总决赛在推理类方案对比中,通常把批处理吞吐、首字延迟、单 token 延迟与整机功耗放在同一张表里。
- 吞吐指标:关注固定延迟约束下的吞吐,而不是无约束峰值,公开材料里常见的是分档数据。
- 精度支持:INT8、FP8 等低精度路径的支持程度,直接影响单位功耗产出。
- 显存与缓存:推理对显存带宽的敏感度高于容量,榜单应单列带宽项。
- 部署成本:整机功耗与机架密度决定长期电费与机房改造成本,属于典型部署方案字段。
示例数据表明,同一档算力的推理方案在功耗相差两成时,三年总拥有成本可能出现明显分化。这也是S16英雄联盟总决赛把部署方案与参数并列展示的原因:榜单只排名次,方案才回答能不能用。
边缘场景榜单:功耗、尺寸与供货周期优先
边缘侧没有机房级的供电与散热条件,选型顺序应当反过来:先看功耗包络与封装尺寸,再看算力。S16英雄联盟总决赛在边缘类方案整理中,把典型功耗、封装尺寸、工作温度范围与长期供货承诺列为必填项。
- 功耗包络:关注典型功耗而非峰值,边缘设备通常按持续负载设计散热。
- 封装与集成:是否集成内存与接口 PHY,直接影响板级面积与开发周期。
- 环境适应:工业级与车规级温度范围不同,榜单需按等级分组,不可混排。
- 供货周期:边缘产品生命周期长,公开的长期供货说明比跑分更有参考价值。
对读者而言,边缘榜单的价值在于快速排除不匹配项。S16英雄联盟总决赛建议先用功耗与封装两道门槛筛掉大半候选,再进入算力与生态的细比,这样选型判断会更清晰。
把榜单用成选型清单的三个动作
榜单不是答案,而是筛选器。第一步,把自己的模型规模、延迟目标与功耗预算写成三行约束;第二步,在S16英雄联盟总决赛的参数库里按场景标签过滤,只保留满足硬约束的条目;第三步,对留下的条目逐项核对部署方案字段,包括整机形态、散热方式与接口配置。
完成这三步后,读者手里剩下的通常不超过五个候选,此时再比较生态成熟度与供货稳定性,判断依据就足够扎实。参数榜单负责缩小范围,部署方案负责确认可行性,两者结合才是完整的选型路径。
网友评论
来自 S16英雄联盟总决赛 社区读者的讨论
训练那块说得在理,互联带宽不够的时候单卡再强也白搭,我们上次扩容就卡在这。
推理榜单要是能加上精度支持的分档就更好了,现在只能自己一个个翻规格书。
功耗和封装先筛确实省事,之前按算力排序看了一圈全是白看。
希望栏目后面能把整机柜方案单独拉个对比,散热和供电差异太大了。